четверг, 22 октября 2020 г.
Объять необъятное


вторник, 25 июня 2019 г.
Задача
Пусть $M$ — квадратная матрица $n\times n$, чьи элементы — рациональные числа. Если её характеристический полином \[\lambda^{n}+c_{n-1}\lambda^{n-1}+\ldots+c_{0}
\] имеет хотя бы один нецелый коэффициент $c_{k}$, то ясно, что никаким преобразованием подобия \[T: M\to T^{-1}MT\] матрицу не сделать целочисленной. Вопрос: верно ли обратное: пусть все $c_{k}$ — целые. Всегда ли существует преобразование подобия $T$, переводящее матрицу в целочисленную?
вторник, 23 апреля 2019 г.
Две задачи по ТФКП
- Рассмотрим интеграл \[ I\left(n,m\right)=\oint_{C}\frac{dx}{2\pi i}\left(\frac{4x+9+5\sqrt{x^{2}+9}}{(x-4)^{2}}\right)^{n}P^{\left(m\right)}\left(x\right)\,, \] где $C$ --- маленький круг с центром в точке $x=4$, $P^{\left(m\right)}\left(x\right)=a_{m}x^{m}+a_{m-1}x^{m-1}+\ldots+a_{0}$ --- полином $m$-ого порядка, $n$ --- целое положительное число. Вычислить $I\left(n,m\right)$ для $m<n-1$.
- Вычислить для $n\in \mathbb{N}$ \[ \operatorname{Res}\limits_{x=2}\frac{1}{x\sqrt{x^{4}+9}}\left(\frac{25x^{2}+100x+44}{5\sqrt{x^{4}+9}-16x+7}\right)^{n}\,. \]
четверг, 29 ноября 2018 г.
Клин 2

- $v$ равно нулю на границе области (в плоскости $z$).
- $\Delta v =0$ внутри области.
- $v$ не равно нулю внутри области.
- Ну, и принцип максимума, конечно.
пятница, 2 декабря 2016 г.
Формула суммирования Пуассона
Так вот, оказывается, с тех пор многое изменилось. Оптимальность гранецентрированной кубической упаковки доказана в 1998 г. Томасом Халесом (Thomas Hales). А в начале этого года совсем молодая девушка-математик Марина Вязовска доказала оптимальность упаковки $\Lambda_8$ в восьмимерье (arXiv:1603.04246). И буквально через неделю вышла работа arXiv:1603.06518 с доказательством оптимальности упаковки для решётки Лича в 24-мерье, основанная на доказательстве в восьмимерье.
Работа Марины Вязовской концептуально очень ясная и опирается на ограничение на плотность упаковки сверху, полученное в работе arXiv:math/0110009. Это простое и, как оказывается, очень мощное ограничение доказывается с помощью формулы суммирования Пуассона. Если Фурье-преобразование функции $f(\boldsymbol{x})$ определить формулой \[\hat{f}\left(\boldsymbol{t}\right)=\int f\left(\boldsymbol{x}\right)e^{2\pi i\boldsymbol{x}\boldsymbol{t}}d\boldsymbol{x}\,,\]то справедлива следующая формула:\[\sum_{\boldsymbol{x}\in\Lambda}f\left(\boldsymbol{x}\right)=\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}\hat{f}\left(\boldsymbol{t}\right)\,.\]Здесь $\Lambda$ — любая решётка в $\mathbb{R}^{n}$, $\left|\Lambda\right|$— объём её элементарной ячейки, $\Lambda^{*}$ — двойственная к $\Lambda$ решётка. Если не гнаться за строгостью, эту формулу можно доказать так: \[ \frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}\hat{f}\left(\boldsymbol{t}\right)=\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}\int f\left(\boldsymbol{x}\right)e^{2\pi i\boldsymbol{x}\boldsymbol{t}}d\boldsymbol{x}=\int f\left(\boldsymbol{x}\right)\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}e^{2\pi i\boldsymbol{x}\boldsymbol{t}}d\boldsymbol{x}=\int f\left(\boldsymbol{x}\right)\sum_{\boldsymbol{y}\in\Lambda}\delta\left(\boldsymbol{y}-\boldsymbol{x}\right)d\boldsymbol{x}=\sum_{\boldsymbol{x}\in\Lambda}f\left(\boldsymbol{x}\right)\,. \] Ну, естественно, чтобы формула имела смысл, нужно чтобы функция и её Фурье-образ достаточно быстро спадали на бесконечности. Если сдвинуть аргумент в правой части на $\boldsymbol{v}$, то из свойств Фурье-преобразования имеем \[ \sum_{\boldsymbol{x}\in\Lambda}f\left(\boldsymbol{x}+\boldsymbol{v}\right)=\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}e^{-2\pi i\boldsymbol{v}\boldsymbol{t}}\hat{f}\left(\boldsymbol{t}\right)\,. \] Это как раз формула (2.1) из math/0110009. Далее доказывается следующая теорема. Допустим, что мы нашли функцию $f$ со следующими свойствами \begin{align*} 1. & f\left(\boldsymbol{x}\right)\leqslant0\text{ для }\left|\boldsymbol{x}\right|\geqslant1\\ 2. & \hat{f}\left(\boldsymbol{t}\right)\geqslant0\text{ для любого }\boldsymbol{t} \end{align*} Тогда центральная плотность (=число центров единичных шаров на единичный объём) периодических упаковок ограничена сверху величиной $\frac{f\left(0\right)}{2^{n}\hat{f}\left(0\right)}$. Вот такое неожиданное утверждение --- где функция, а где упаковка.
Доказательство совсем не сложное: пусть периодичность упаковки определяется решёткой $\Lambda$, причём в элементарной ячейке находится $N$ шаров. Для дальнейшего удобно считать, что радиус шаров равен $1/2$, так что расстояния между центрами любых двух не меньше единицы. Пусть расположение центров в элементарной ячейке задаётся векторами $\boldsymbol{v}_{1},\ldots,\boldsymbol{v}_{N}$. Запишем формулу суммирования Пуассона в таком виде \begin{equation} \sum_{j,k=1}^{N}\sum_{\boldsymbol{x}\in\Lambda}f\left(\boldsymbol{x}+\boldsymbol{v}_{j}-\boldsymbol{v}_{k}\right)=\sum_{j,k=1}^{N}\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}e^{-2\pi i\left(\boldsymbol{v}_{j}-\boldsymbol{v}_{k}\right)\boldsymbol{t}}\hat{f}\left(\boldsymbol{t}\right)=\frac{1}{\left|\Lambda\right|}\sum_{\boldsymbol{t}\in\Lambda^{*}}\left|\sum_{k=1}^{N}e^{2\pi i\boldsymbol{v}_{k}\boldsymbol{t}}\right|^{2}\hat{f}\left(\boldsymbol{t}\right)\,.\label{eq:Poisson1} \end{equation} Аргумент $\boldsymbol{x}+\boldsymbol{v}_{j}-\boldsymbol{v}_{k}$ в левой части можно рассматривать как вектор, соединяющий центры шаров в точках $\boldsymbol{x}+\boldsymbol{v}_{j}$ и $\boldsymbol{v}_{k}$. Поэтому он может быть по модулю меньше единицы только если это один и тот же шар, т.е. $\boldsymbol{x}=0$, $j=k$. А значит, левая часть не больше $Nf\left(0\right)$. В правой части все слагаемые неотрицательны, поэтому она не меньше одного члена суммы с $\boldsymbol{t}=0$, т.е. $N^{2}\hat{f}\left(0\right)/\left|\Lambda\right|$. Поэтому получаем \[ Nf\left(0\right)\geqslant N^{2}\hat{f}\left(0\right)/\left|\Lambda\right| \] Поскольку наши шары имеют радиус $r=1/2$, центральная плотность равна $\delta=\frac{Nr^{n}}{\left|\Lambda\right|}=\frac{N}{\left|\Lambda\right|2^{n}}$ и мы имеем желаемое утверждение \[ \delta\leqslant\frac{f\left(0\right)}{2^{n}\hat{f}\left(0\right)}\,. \] А что же сделала Марина Вязовска? Она построила для $\mathbb{R}^{8}$ такую функцию $f$, что выведенная оценка сверху оказывается совпадающей с плотностью решётки $\Lambda_8$, которая определяется как \begin{equation}\Lambda_8 = \left\{(x_i) ∈ \mathbb{Z}^8 \cup (\mathbb{Z}+1/2)^8 \bigg|\sum x_i = 0 (\mathrm{mod} 2)\right\}.\end{equation} Ясно, что это сделать ну очень непросто: те члены сумм в обеих частях равенства \eqref{eq:Poisson1}, которыми мы пренебрегали для получения неравенства, должны быть равны нулю чтобы позволить точное равенство. Кстати, уже из определения решётки $\Lambda_8$ видно, чем замечательно 8-мерное пространство. Расстояние между точками решетки $(0,0,0,0,0,0,0,0)$ и $(\frac12,\frac12,\frac12,\frac12,\frac12,\frac12,\frac12,\frac12)$ равно $\sqrt{2}$, как и расстояние между $(0,0,0,0,0,0,0,0)$ и $(1,1,0,0,0,0,0,0)$. Можно посчитать контактное число: \[240=4{8 \choose 2}+2+2{8 \choose 2}+{8\choose 4}\] Как построена требуемая функция напишу как-нибудь в другой раз.
пятница, 23 мая 2014 г.
Что-то рядом с Меллином.
Рассмотрим линейное пространство гладких функций $\phi(x)$ на $[0,\infty)$, спадающих быстрее любого полинома на бесконечности и разложимых в ряд Тейлора в окрестности нуля. Определим в этом пространстве преобразование \[\phi(x)\to \tilde{\phi}_m=I^m[\phi],\,m\in\mathbb{Z}\,,\] где $I^m[\phi]$ --- такой функционал \[I^m[\phi]=\left\{\begin{array}{cc}\frac{1}{\Gamma(m)}\int_0^\infty dx x^{m-1}\phi(x)\,,& m>0\\ (-1)^m\phi^{(-m)}(0)\,,&m\leqslant 0\end{array}\right.\]
Красота этого определения --- в том, что справедливы следующие формулы \[I^m[-d\phi/dx]=I^{m-1}[\phi]\,,\quad I^m[x\phi]=m I^{m+1}[\phi]\] Вот интересно, как написать обратное преобразование (если оно существует, конечно)?
понедельник, 19 мая 2014 г.
Визуальное решение задач на построение
ЗАДАЧА 981 (Diofant.ru). Перпендикуляр к диаметру 'Дана окружность o и прямая линия l, которая проходит через ее центр. На окружности отмечена точка A, не лежащая на прямой. При помощи одной линейки без делений постройте перпендикуляр от точки к прямой.Для решения таких задач я использую свой скрипт. Решить-то я решил, но поскольку задача проверяется в ручном режиме, надо было еще написать решение. Поэтому вчера я немного допилил скрипт (если кому-то интересно, смотреть как его подключить в коде) и теперь он худо-бедно документирует действия. Вот, можно попробовать решить вышеупомянутую задачу. Точки на пересечениях двух объектов ставятся их последовательным выделением (при включенном инструменте line).
суббота, 15 марта 2014 г.
Про числа и игры
Вот, недавно стал читать книгу Конвея "О числах и играх". Много лет назад прочитал вот здесь про комбинаторную теорию в Го. В частности, прочитал про инфинитезимали, и это было круто. Сейчас решил перечитать, и нашел ссылку на Конвея. Вот цитата из первого параграфа:
"Дедекинд (а до него автор — как считается, Евдокс — пятой книги Евклида) строил вещественные числа из рациональных. Его метод заключался в том, чтобы разделить рациональные числа на два множества L и R так, чтобы ни одно число из L не было больше никакого числа из R, и использовать это "сечение" для определения нового числа {L | R} в случае, если ни L и R не имеют экстремальной точки."Фактически, вот это самое дедекиндовское определение и берется далее за основу:
"Если L, R — два множества чисел, и ни один элемент из L не ⩾ любого элемента из R, то есть число {L | R}. Все числа строятся таким образом."Отличие от дедекиндовского определения в том, что никаких чисел adhoc вводить не требуется. Конечно, еще нужно определить отношение ⩾ для таких чисел и операцию сложения (интересующимся смотреть книжку). Последняя позволяет отождествить определяемые числа с нормальными. Например, ноль выглядит как {∅ |∅}={|}. Вообще, одно и то же число можно представить разными способами, но это не страшно, с обыкновенными дробями тоже так.
Но, конечно, самое интересное начинается, если рассматривать пары {L|R}, в которых нет условий на элементы. Получаем определение комбинаторных игр на двоих:
"Если L, R — два множества игр, то есть игра {L | R}. Все игры строятся таким образом."Игры тоже можно складывать и вычитать. Числа в этом подходе — частный случай игр. А есть игры, числами не являющиеся, в частности, упомянутые инфинитезималы. Но про это как-нибудь в другой раз.
Ну, и скрипт, конечно. Кстати, обнаружил, что поддерживается ползунок — <input type="range" min="0" max="10"... />.
| Двоичное число | результат | |
| -1.1 | ||
вторник, 24 сентября 2013 г.
Разложение на простые дроби (профессиональное)
A+B+C&=1,\\-9 A-7 B-4 C&=-8,\\18 A+6 B+3 C&=-3.
\end{align*}Решая эту систему, наконец, находим \begin{equation*}
\frac{x^2-8x-3}{(x-{\color{red}1})(x-{\color{green}3})(x-{\color{blue}6})}=-\frac{1}{x-{\color{red}1}}+\frac{3}{x-{\color{green}3}}-\frac{1}{x-{\color{blue}6}}
\end{equation*} И да, я, вроде, тоже так когда-то делал. Пока не знал ТФКП.
А теперь я делаю так:\begin{multline*}
\frac{x^2-8x-3}{(x-{\color{red}1})(x-{\color{green}3})(x-{\color{blue}6})}=\frac{{\color{red}1}^2-8\cdot{\color{red}1}-3}{(x-{\color{red}1})({\color{red}1}-{\color{green}3})({\color{red}1}-{\color{blue}6})}\\
+\frac{{\color{green}3}^2-8\cdot{\color{green}3}-3}{({\color{green}3}-{\color{red}1})(x-{\color{green}3})({\color{green}3}-{\color{blue}6})}
+\frac{{\color{blue}6}^2-8\cdot{\color{blue}6}-3}{({\color{blue}6}-{\color{red}1})({\color{blue}6}-{\color{green}3})(x-{\color{blue}6})}\\
=-\frac{1}{x-{\color{red}1}}+\frac{3}{x-{\color{green}3}}-\frac{1}{x-{\color{blue}6}}
\end{multline*} Если в знаменателе есть степени, нужно, естественно, итерировать. Кстати, рецепт обобщается и на случай нескольких переменных. Научите ребенка — и он сможет при случае щегольнуть быстрым счетом в школе.
понедельник, 16 сентября 2013 г.
Про идеалы
Вообще, кольцо --- это множество, замкнутое относительно двух операций со свойствами сложения и умножения. Эти операции поэтому часто так и называют: сложение и умножение. Правда, коммутативность умножения не требуется, но нас интересует как раз кольцо с коммутативным умножением --- коммутативное кольцо. Ну еще хотят чтобы был нуль, и был противоположный элемент. Существование противоположного элемента позволяет определить в этом множестве и операцию вычитания по формуле $a-b\equiv a+(-b)$, где $-b$ --- элемент, противоположный $b$. Заметим, что существование единичного элемента и обратного элемента для ненулевого $a$ не требуется, и в этом принципиальное отличие кольца от поля.
Говоря неформально, в кольце деление даже на ненулевой элемент может быть невыполнимо. И, естественно, встает вопрос, а когда же деление все-таки выполнимо? Возьмем элемент кольца $a$ и спросим, какие элементы $b$ на него делятся, для каких $b$ разрешимо уравнение \begin{equation}b=ca.\label{eq1}\end{equation} Множество допустимых значений $b$ является примером идеала.
Возьмем самый простой пример коммутативного кольца — множество целых чисел $\mathbb{Z}$ с обычным сложением и умножением. Тогда, например, множество чисел, кратных числу $a$ является идеалом.
Можно расширить определение идеала так: пусть заданы несколько элементов кольца $a_1,\ldots,a_n$. Тогда идеал определим как множество значений $b$ (из кольца, конечно), для которых уравнение\begin{equation}b=c_1a_1+\ldots+c_na_n\label{eq2}\end{equation} разрешимо относительно $c_1,\ldots,c_n$ (в кольце, конечно). Про такие идеалы говорят, что они порождаются элементами $a_1,\ldots,a_n$. Для кольца целых чисел наше обобщение \eqref{eq2} не добавляет ничего нового. Чтобы это понять, заметим, что, во-первых, достаточно рассматривать идеалы, порожденные натуральными числами. Во-вторых, идеал, порожденный натуральными числами $a_1,\ldots,a_n$, совпадает с идеалом, порожденным $\mathrm{GCD}(a_1,\ldots,a_n)$. Таким образом, в кольце целых чисел не только каждому натуральному числу соответствует идеал, но и наоборот, что открывает возможность переформулировать утверждения о натуральных числах в утверждения об идеалах. Вот, например, идеал, соответствующий простому числу (по понятным причинам называется простым идеалом), --- это собственный идеал (собственный $\equiv$ не совпадающий со всем кольцом), обладающий следующим свойством: для любого его элемента, имеющего вид произведения, по-крайней мере один из сомножителей также принадлежит идеалу. Теперь, когда у нас есть такое определение, мы можем его использовать для идеалов любых коммутативных колец, и, естественно, надеяться, что у этой и подобных конструкций есть простой смысл и большая польза.
Вот, например, рассмотрим полиномиальное кольцо --- множество полиномов от $n$ переменных $x_1,\ldots,x_n$ с комплексными, скажем, коэффициентами. Полиномы, как и целые числа, можно складывать и умножать. Обозначать это множество будем так: $\mathbb{C}[x_1,\ldots,x_n]$. В этом кольце наше обобщение \eqref{eq2} уже не сводится к \eqref{eq1}. Для кольца целых чисел каждый идеал у нас соответствовал натуральному числу, а для кольца полиномов идеалу можно придать гораздо более интересный смысл. А именно, идеалу, порожденному полиномами $p_1,\ldots,p_n$, сопоставим алгебраическое многообразие в $R^n$, заданное полиномиальными уравнениями \begin{align}p_1=0\nonumber\\\vdots\label{eq3}\\p_n=0\nonumber\end{align}Только вот это соответствие неоднозначное. В частности, если мы любой полином в системе \eqref{eq3} заменим на его степень, многообразие, очевидно не поменяется, а идеал, вообще говоря, поменяется. Чтобы соответствие было однозначным, нам нужно рассматривать не все идеалы, а то, что называется радикал-идеалы. Радикал-идеал $\mathcal{I}$ --- это идеал, для которого из условия $a^n\in \mathcal{I}$ следует $a\in \mathcal{I}$. Так вот соответствие между радикал-идеалами и алгебраическими многообразиями однозначно. Это означает, что, исследуя радикал-идеалы, можно исследовать алгебраические многообразия. Кстати, радикал-идеалы в кольце $\mathbb{Z}$ соответствуют натуральным числам, в разложении которых на простые нет степеней. Поэтому радикал-идеалы называются еще полупростыми. Очевидно, что простые идеалы являются также полупростыми, а обратное не всегда верно.
 | |||
| Пример приводимого многообразия, заданного уравнением $(x^2+y^2-4)(x^2-y)=0$ |
Красота идеальной математики на этом не кончается, но вот пост пора закруглять. Могу только порекомендовать для самообразования книжку Кокс, Литтл, О'Ши Идеалы, многообразия и алгоритмы.
P.S. Все, можно статьи писать прямо в блоггере. Последний MathJax поддерживает нумерацию уравнений + ссылки через \ref и \eqref. Чтобы узнать как это включить, смотреть в коде поста скрипт с src="...MathJax.js"
среда, 10 апреля 2013 г.
Булевы алгебры, проекторы и квантовые игры
То же самое можно сказать более вычурно: Функции $n,a,o$ задают булеву алгебру на множестве корней уравнения $x^2-x=0$.
Кажется, что это утверждение не несет ничего нового, ведь уравнение как раз и имеет два корня --- $0$ и $1$. Однако тут мы вспоминаем, что это уравнение является также определяющим уравнением для проекторов. Легко проверить, что если мы возьмем множество коммутирующих проекторов, замкнутое относительно операций $n$ и $a$, то приведенные выше функции определяют булеву алгебру. Далее операции $n,a,o$ будем обозначать как в логике:$\lnot,\land,\lor$.
Кто-то скажет "что толку в такой булевой алгебре". Попробую объяснить. Вспомним, что в квантовой механике коммутирующие эрмитовы операторы соответствуют одновременно измеримым величинам. Более того, если, скажем, есть у нас проектор $P_0=|\psi_0\rangle\langle\psi_0|$ на какое-нибудь состояние, то вероятность обнаружения этого состояния в состоянии $\psi$ равна среднему от проектора \[\langle\psi|P_0|\psi\rangle\] Ага, теперь все становится понятно. Пусть у нас есть запутанное состояние двух спинов. Например, такое\[|\psi\rangle=\frac1{\sqrt{2}}(|\uparrow\rangle|\downarrow\rangle-|\downarrow\rangle|\uparrow\rangle).\] И мы, скажем, хотим определить вероятность измерения, которое покажет, что первый спин торчит вдоль оси $z$ или второй спин торчит вдоль оси $x$ (или то и другое). Очень просто,эта вероятность равна:\[\langle\psi|P_1^z\lor P_2^x|\psi\rangle=\frac34,\] где $P_1^z=\frac12(1+\sigma_1^z)$, $P_2^x=\frac12(1+\sigma_2^x)$. То есть наше определение измерения напрямую транслировалось в ответ, даже задумываться не пришлось. Это, конечно, простейший пример, но идея понятна. Например, операторы, соответствующие особо запутанным измерениям можно, перед тем как усреднять, упрощать по правилам логики.
Заметим, между прочим, что определенные функции $n,a,o$ имеют простую классическую вероятностную интерпретацию: если $x$ и $y$ --- вероятности независимых событий, то $n,a,o$, соответственно, вероятности того, что первое не произойдет, что произойдут оба и что произойдет хотя бы одно. Результаты измерения спинов в запутанном состоянии, вообще говоря, не являются независимыми, но для проекторов действуют все те же простые правила.
Дальше воображение рисует кучу приложений, например, в теории квантовых игр или в квантовых компьютерах.
Может кто это уже придумал все, а? Уж больно красиво.
понедельник, 8 апреля 2013 г.
Клин
Рассмотрим матрицу \[
\Lambda_{\mathbf{p}}=\frac12\left(1+\frac{\varepsilon+\beta m}{p^2}\boldsymbol{\alpha}\mathbf{p}\right).
\] В голове не укладывались 4 утверждения, касающиеся этой матрицы:
- $\Lambda_{\mathbf{p}}$ --- проектор, т.е. $\Lambda_{\mathbf{p}}^2=\Lambda_{\mathbf{p}}$.
- $\Lambda_{\mathbf{p}}u_{\mathbf{p}}=u_{\mathbf{p}}$, т.е., это проектор на пространство решений уравнения $[\varepsilon-\boldsymbol{\alpha}\mathbf{p}-\beta m]u_{\mathbf{p}}=0$.
- $\Lambda_{\mathbf{p}}+\Lambda_{-\mathbf{p}}=1$, откуда следует, что $\Lambda_{\mathbf{p}}\Lambda_{-\mathbf{p}}=0$.
- $u^{\dagger}_{\mathbf{p}}u_{\mathbf{-p}}\neq0$.
среда, 27 марта 2013 г.
Еще идефикс
Проблема в том, что когда картинка понятна, очень хочется ее нарисовать, и сопротивляться этому желанию у меня пока не получается. Иначе картинка будет висеть в бэкграунде и тормозить весь мыслительный процесс. Вот только в данном случае нужно не нарисовать, а анимировать. К счастью, Wolfram Mathematica заботится о нас, толкает свой CDF формат (как альтернативу PDF-у, что-ли?). Ладно, попробуем. Ниже результат.
Когда ползунок в самой правой позиции, имеем дважды накрытую сферу Римана, на которой однозначно определена наша функция $f(z)$. Четыре конца красных линий соответствуют корням нашего полинома $\pm1,\pm i$. Сами линии обозначают один из возможных способов выбрать разрезы.
P.S. Главное страдание --- выдумать подходящую функцию, интерполирующую между двумя крайними положениями. Первоначальная простая, как три копейки, мысль --- интерполировать как $(1-t)*тор+t*сфера2$ --- дает убогий результат.
пятница, 23 марта 2012 г.
Научная жизнь
Ну кто бы мог подумать, что с виду нормальный, эрмитовый гамильтониан может привести к эффективно неупругому рассеянию? Кто бы мог подумать, что стационарные решения могут быть локально неинтегрируемые с квадратом, да и просто невозводимые в квадрат, а кроме того, еще и странно вырожденными в радиальной задаче? И при этом пригодными для разложения временного решения?
Ниже --- анимация рассеяния сферического пакета, локализованного изначально на больших $r$. Отразилась только часть пакета, а часть "прилипла". Если вам такая динамика не кажется странной, или даже невозможной, значит вы плохо учили квантовую механику.
P.S. Теперь на очереди другая задача --- написание пакета, реализующего давнюю тайную мечту любого ученого --- решение всех проблем в автоматическом режиме, включая в перспективе и написание статьи с изложенными результатами. Когда напишу --- моя миссия на работе сведется к нажатию кнопки утром и засылке в архив готовой работы вечером. Пока написанное выглядит так:

вторник, 21 февраля 2012 г.
Матроиды для чайников
Чтобы определить матроид, определим сначала бинарную группу цепей. Бинарную группу можно наглядно определить так
Бинарная группа цепей --- множество, состоящее из N-значных двоичных чисел (не обязательно всех) и замкнутое относительно групповой операции --- побитного исключающего или. Единицей группы является $\underbrace{0\ldots 0}_{N\text{ нулей}}$ и каждый элемент является себе обратным.В теоретико-множественном определении нужно заменить N-значные двоичные числа на подмножества N-элементного множества, а исключающее или --- на исключающее объединение $(\#1\backslash\#2)\cup(\#2\backslash\#1)$. Почему интересна такая конструкция, потому что эта группа играет важную роль в теории графов.
Пусть у нас есть граф с N ребрами. Возьмем часть его вершин в левую руку (множество этих вершин назовем $A$), а остальные --- в правую ($B$), растянем и порежем все ребра, идущие из одной руки в другую. Множество ребер, которые оказались разрезанными назовем разрезом. Все разрезы данного графа, как нетрудно сообразить, образуют некоторую бинарную группу цепей, которую мы будем обозначать $C$. Действительно, разрез, соответствующий исключающему объединению двух разрезов получается разбиением множества вершин на \[A^{\prime\prime}=(A\cap A^{\prime})\cup (B\cap B^{\prime})\quad\text{ и }\quad B^{\prime\prime}=(A\cap B^{\prime})\cup (B\cap A^{\prime}).\] Кстати, множество ребер, имеющих общую вершину тоже, очевидно, является разрезом (защипнем эту общую вершину и отрежем все ребра, соединяющие ее с остальным графом).
Есть другая бинарная группа цепей, связанная с множеством ребер графа. Рассмотрим все подграфы графа, для которых в каждой вершине сходится четное число ребер. Ясно, что множества ребер таких подграфов (собственно, цепи) образуют бинарную группу цепей $L$.
Заметим, что задание бинарной группы цепей (и, в частности, групп $C$ и $L$) полным перечислением ее элементов представляется довольно избыточным. Вообще, наиболее экономичный способ описания --- это задать мультипликативный базис группы. Понятие матроида бинарной группы цепей лежит где-то на полдороги между полным множеством элементов группы и ее мультипликативным базисом.
Перед тем, как давать формальное определение, поясним суть дела на примере наших групп $C$ и $L$. Рассмотрим сначала некоторый разрез. Может так оказаться, что после разреза в одной или обоих руках окажется несвязный граф (см. картинку). Такой разрез может быть выполнен в два приема и поэтому уж точно бесполезен для построения базиса. Можно сказать, что такой разрез неэлементарный.
Аналогично, многие цепи являются неэлементарными. Это так, если подграф, им соответствующий, несвязен или содержит вершины со степенью 4 или выше (см. пример справа). Вот если мы исключим из $C$ и $L$ (как множеств) неэлементарные элементы, а заодно и единицу группы --- пустое множество, оставшаяся часть и будет называться матроидом. Итак, на теоретико-групповом языке матроид бинарной группы цепей--- подмножество всех элементарных элементов группового множества, т.е., всех непустых элементов, которые не включают в себя никакого другого элемента в качестве подмножества. Для нашего чайниковского определения бинарной группы
Матроид бинарной группы цепей --- подмножество всех таких ненулевых чисел из группового множества, которые обязательно меняются при побитном ИЛИ с любым элементом группы.Все, хватит пока. Про алгоритм Татта напишу как-нибудь в другой раз.
P.S. Кстати, картинки рисованы в SVG-edit, не выходя из браузера, а затем скопипасчены прямо в пост.
понедельник, 17 января 2011 г.
Плоская шутка
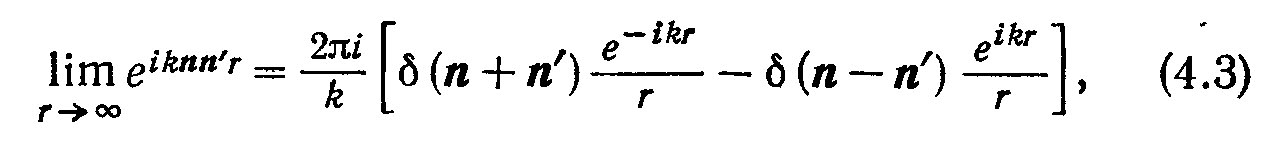
\[
e^{ikr\mathbf{n}\mathbf{n}^{\prime}}=\sum(2l+1) i^{l}P_{l}(\mathbf{n}\mathbf{n}^{\prime})
j_{l}(kr)
\]
и устремляем $r$ к бесконечности. Используем асимптотику функции Бесселя
\[
i^{l}j_{l}(kr)\stackrel{r\to\infty}{\to}
\frac{i}{2kr}\left((-1)^le^{-ikr}-e^{ikr}\right)
\]
и сумму полиномов Лежандра
\[
\sum\left( 2l+1\right) P_{l}(\mathbf{n}\mathbf{n}^{\prime})=4\pi\delta(\mathbf{n}-\mathbf{n}^{\prime})
\]
(ну, и сумму с заменой $\mathbf{n}\to-\mathbf{n}$) и получаем желаемое.
Но все-же, формула выглядит подозрительно, слева стоит функция с единичным модулем,а справа что? Вопрос:где подвох.
пятница, 2 июля 2010 г.
Подписали несовершеннолетних
Мне, конечно, кажется, что все про миноры со знаком должны знать, но на всякий случай объясню. Как учат нас старшие товарищи, объяснять как раз и нужно то, что, в общем-то, объяснять не нужно. А то, что действительно нужно объяснять, нужно старательно заметать под ковер дабы не вызвать в слушателях ненужных сомнений. Вот и я обнаружил и доказал недавно два красивых тождества и ну очень хотел впихнуть их в свой вклад в труды конференции, но когда дело до этого дошло, понял, что погрязну в объяснениях. Ограничился тем, что привел в статье частный случай одного из них и написал поясняющую все и сразу фразу, оканчивающуюся на "presented elsewhere". Но зато успел отправить сегодня (в дедлайн).
Да, про миноры со знаком. Если есть у нас матрица
\[\left[\begin{array}{ccc}r_1^1&\ldots&r_N^{1}\\\vdots&\ddots&\vdots\\r_1^N&\ldots&r_N^N\end{array}\right]\]
будем называть ее $\left(\begin{array}{c}i_1,\ldots,i_m\\j_1,\ldots,j_m\end{array}\right)$-минором (обозначение только что придумал) детерминант матрицы, которая получается из исходной вычеркиванием столбцов под номерами $i_1,\ldots,i_m$ и строк под номерами $j_1,\ldots,j_m$. Видим, что минор симметричен по верхним и по нижним индексам. А минор со знаком — антисимметричен. Потому что от просто минора отличается таким множителем
\[(-1)^{i_1+\ldots+i_m+j_1+\ldots+j_m}\sigma(i_1,\ldots, i_m)\sigma(j_1,\ldots, j_m)\]
Здесь $\sigma(i_1,\ldots, i_m)=\pm 1$ обозначает четность перестановки, которую нужно сделать чтобы упорядочить по возрастанию ряд чисел $i_1,\ldots, i_m$. Обозначать этот страх будем так
\[R_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}=(-1)^{i_1+\ldots+i_m+j_1+\ldots+j_m}\sigma(i_1,\ldots, i_m)\sigma(j_1,\ldots, j_m)\left(\begin{array}{c}i_1,\ldots,i_m\\j_1,\ldots,j_m\end{array}\right)\]
Например, детерминант всей матрицы будет равен
\[R=\left(\begin{array}{с}\, \\\, \end{array}\right)=\left|\begin{array}{ccc}r_1^1&\ldots&r_N^{1}\\\vdots&\ddots&\vdots\\r_1^N&\ldots&r_N^N\end{array}\right|\]
Если наша матрица состоит из независимых переменных, то мы можем любой минор со знаком получить простым дифференцированием $R$:
\[R_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}=\frac{\partial}{\partial r_{i_1}^{j_1}}\ldots \frac{\partial}{\partial r_{i_m}^{j_m}} R\]
Теперь вернемся к теореме Карла Якоби (см. предыдущий пост)
В терминах наших миноров со знаком эту теорему можно записать так"If the determinant of a block $= R$, the determinant of any minor of the $m$th degree of the adjugate block is the product of $R^{m-1}$ and the coefficient which, in $R$, multiplies the determinant of the corresponding minor."(C.Jacobi)
\[m! R_{j_1}^{[i_1}\ldots R_{j_m}^{i_m]}=R^{m-1}R_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}\]
Я этого сразу не понял, но ведь мне никто и не подсказал. Так что эквивалентность выписанной формулы теореме Якоби должна быть понятна. Вообще-то, это уравнение говорит чуть больше, чем теорема Якоби, но это "чуть больше" — тривиальное утверждение, что если есть повторяющиеся верхние или нижние индексы, то ноль с обеих сторон и довольно простое утверждение о том, что знак правильный.
Кстати, тождество
\[C_{m}^k R_{j_1\ldots j_k}^{[i_1\ldots i_k}\,R_{j_{k+1}\ldots j_m}^{i_{k+1}\ldots i_m]}=R\,R_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}\]
Теперь собственно к найденным мной (приоритет!) тождествам. Я их умею доказывать, используя теорему Якоби, но кто же эту скуку в состоянии будет прочитать. А между тем, сами тождества — красоты неописуемой (в смысле, легче предъявить тождества, чем описать их красоту). Рассмотрим такой оператор
\[D_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}=\left|\begin{array}{ccc}\frac{\partial}{\partial r_{i_1}^{j_1}}&\ldots&\frac{\partial}{\partial r_{i_m}^{j_1}}\\\vdots&\ddots&\vdots\\\frac{\partial}{\partial r_{i_1}^{j_m}}&\ldots&\frac{\partial}{\partial r_{i_m}^{j_m}}\end{array}\right|\]
Первое тождество такое
\begin{equation}D_{j_1,\ldots,j_m}^{i_1,\ldots,i_m} (R)^{\alpha}=\alpha (\alpha+1)\ldots (\alpha+m-1)R_{j_1,\ldots,j_m}^{i_1,\ldots,i_m} (R)^{\alpha-1}\end{equation}
А теперь рассмотрим симметричную матрицу
\[\left[\begin{array}{ccc}s_{1,1}&\ldots&s_{1,N}\\\vdots&\ddots&\vdots\\s_{1,N}&\ldots&s_{N,N}\end{array}\right]\]
Мне-то в статье как раз такая нужна была. Соответственно, миноры будем буквой $S$ обозначать. Вопрос: можно ли похожую формулу написать для этого случая? Оказывается, можно. Используем теперь такой оператор
\[\tilde{D}_{j_1,\ldots,j_m}^{i_1,\ldots,i_m}=\left|\begin{array}{ccc}2^{\delta_{i_1,j_1}-1}\frac{\partial}{\partial s_{i_1,j_1}}&\ldots&2^{\delta_{i_m,j_1}-1}\frac{\partial}{\partial s_{i_m,j_1}}\\\vdots&\ddots&\vdots\\2^{\delta_{i_1,j_m}-1}\frac{\partial}{\partial s_{i_1,j_m}}&\ldots&2^{\delta_{i_m,j_m}-1}\frac{\partial}{\partial s _{i_m,j_m}}\end{array}\right|\]
Так вот, второе тождество выглядит так
\begin{equation}\tilde{D}_{j_1,\ldots,j_m}^{i_1,\ldots,i_m} (S)^{\alpha}=\alpha (\alpha+1/2)\ldots (\alpha+(m-1)/2)S_{j_1,\ldots,j_m}^{i_1,\ldots,i_m} (S)^{\alpha-1}\end{equation}
Вот такая производная по минору.
понедельник, 28 июня 2010 г.
Матрицы и уравнения
Вот что он придумал. Пусть, например, нам нужно вычислить детерминант матрицы
" If the determinant of a block $= R$, the determinant of any minor of the $m$th degree of the adjugate block is the product of $R^{m-1}$ and the coefficient which, in $R$, multiplies the determinant of the corresponding minor."(Jacobi)
PS Только что выяснил, что описанный метод вычисления детерминантов можно найти в английской википедии в соответствующей статье. Там тождество Доджсона называется Desnanot-Jacobi identity, и это, по-моему, правильно.
вторник, 15 июня 2010 г.
Ускорение сходимости
Недавно пришлось разобраться в вопросе об ускорении сходимости последовательностей. До этого я был в полной уверенности, что знаю достаточно об этом, а чего не знаю — и не надо никогда. Но оказалось, что бывает надо. Расскажу про один простой метод, описанный в статье Дэвида Бродхерста (Broadhurst). Статья, конечно, не про метод.
Рассмотрим в качестве подопытной свинки $\zeta$-функцию Римана:
\[\zeta(n)=\sum_{k=1}^{\infty}\frac 1{k^n}\]
Просуммировав $N$ членов суммы, получим примерно $P\approx (n-1)\log_{10}N$ десятичных знаков. Можно, конечно, "пришить хвост", т.е., аппроксимировать остаток суммы интегралом, но это не может изменить того факта, что сходимость — логарифмическая $P\propto \log N$. Меняется только коэффициент пропорциональности. Справедливости ради заметим, что для многих практических целей достаточно, чтобы этот коэффициент был достаточно большим. Но что, если нам все-же хочется уметь вычислять такие суммы с высокой точностью?
Замечательный метод ускорения сходимости для таких последовательностей описан в вышеупомянутой статье. Я сначала не особенно сильно на него надеялся. Интуитивно мне казалось, что если мы вычислили $N$ первых членов суммы, то лучшее, что мы с ними можем сделать — просто сложить. Фокус в том, что мы не просто знаем эти члены, но еще и знаем кое-что об остатке $r_k$. А именно, функция $k^{n-1}r_k$ раскладывается в ряд вблизи точки $k=\infty$. Это позволяет построить некоторую взвешенную сумму первых $N$ членов так, что $P\propto N$!
В качестве иллюстрации прилагаю маленький скрипт, написанный по мотивам вышеупомянутой статьи, который вычисляет $\zeta(n)$. Внимательный взгляд найдет пару отличий от описанного в статье. Поскольку написан он на javascript, то точность в какой-то момент теряется (точнее, не растет), но это проблемы вычислений с фиксированной точностью. Вбейте в форму ниже $N$ и $n$ и нажмите кнопку.
Если кому-то стало интересно, предлагаю выяснить как выглядит вектор весов и определить коэффициент пропорциональности между P и N (экспериментально). Результат может удивить. Еще один вопрос — какой должна быть рабочая точность? Для удобства ниже — упрощенный (без учета потери точности) код скрипта
 function Zeta(N,n) {

  var terms= [0];

  //accumulating from above

  for(var i=N;i>0;i--) {

   terms.push(terms[terms.length-1]+1/Math.pow(i,n));

  };

  //acceleration starts

  for(var m=0;m<N;m++) {

  for(var k=0;k<(N-m);k++) {

   terms[k]=((N-k)*terms[k]-(N-k-m-n+1)*terms[k+1])/(m+n-1)

  };

  };

  //direct sum

  document.getElementById('direct').value=terms[N];

  //accelerated

  document.getElementById('accelerated').value=terms[N]-terms[0];

 }